05 Ontology 与其他技术方案的对比:优势、劣势与组合方式
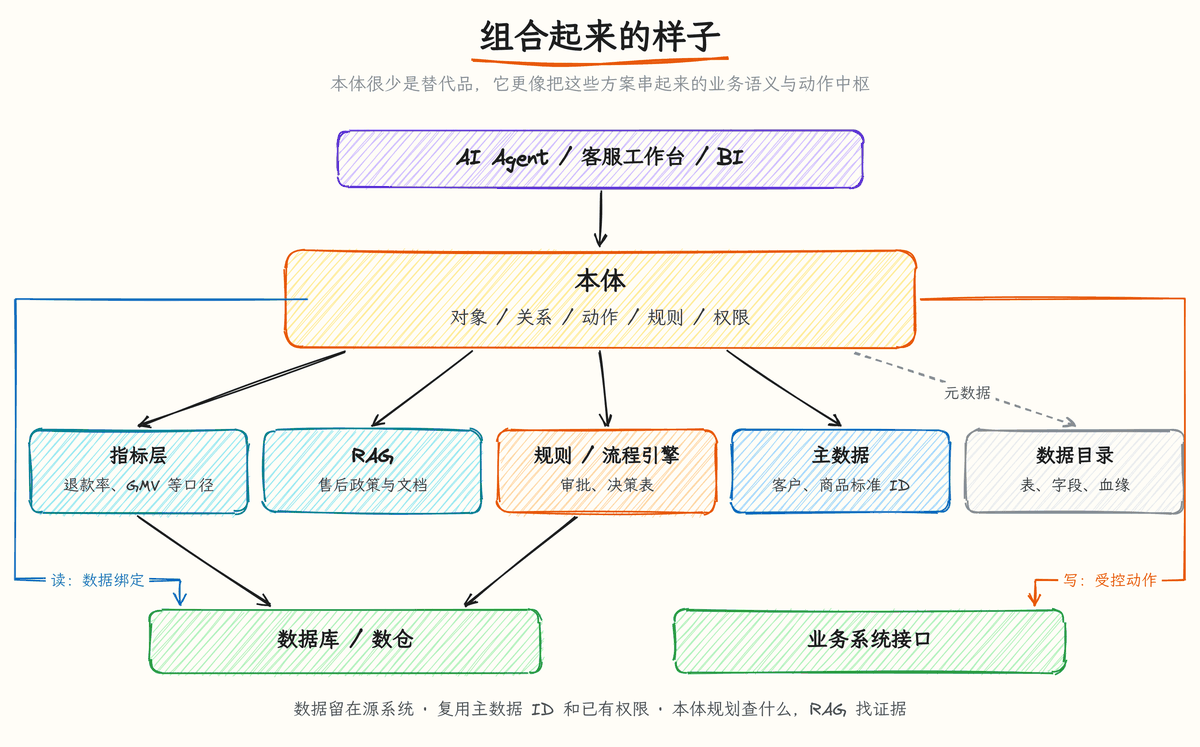
听到"本体",很多人的第一反应是:"这和我们已有的数仓、数据目录、知识图谱、主数据有什么区别?"这一篇把十类常见方案逐一和本体对比,说清各自回答什么问题、本体比它强在哪、弱在哪,以及怎么组合使用。先说结论:本体很少是替代品,它更像把这些方案串起来的业务语义与动作中枢。
1. 一张总表
| 方案 | 核心回答的问题 | 擅长 | 不擅长 | 与本体的组合方式 |
|---|---|---|---|---|
| 关系数据库 / 数仓 | 数据怎么存、怎么算 | 事务、海量计算、成熟生态 | 表达业务含义、跨系统身份 | 数据留在原处,本体做映射和受控写回 |
| 数据目录 / 元数据 | 有哪些数据资产、谁负责 | 资产盘点、血缘、治理流程 | 对象间业务关系、动作 | 目录提供"物理事实",本体提供"业务语义" |
| 指标语义层 | 指标怎么算、口径是什么 | 统一度量、BI 与问数 | 对象身份、关系推理、写操作 | 本体定义对象,指标层定义度量 |
| 知识图谱 | 具体事实之间怎么连 | 多跳查询、关系发现 | 约束与动作(单独使用时) | 本体是图谱的蓝图和规则 |
| 主数据管理 MDM | 某类核心实体的权威记录 | 黄金记录、数据管家、写回源系统 | 跨领域关系和业务动作 | 共享稳定实体 ID,本体负责跨域连接 |
| RAG / 向量库 | 哪些文档片段相关 | 非结构化证据检索 | 业务状态、逻辑相关性 | 本体规划查什么,RAG 找证据 |
| BI 报表 | 业务表现怎么看 | 可视化、固定分析 | 从洞察到行动 | 建在本体和指标之上,结论可触发动作 |
| 数字孪生 | 物理系统现在什么状态 | 设备、空间、遥测 | 商业流程与审批 | 本体可视为业务层面的孪生 |
| 规则引擎 / BPM | 条件满足时做什么、流程怎么走 | 规则执行、流程编排 | 规则所指对象的统一定义 | 本体定义名词,规则和流程引用它 |
| 大模型微调 | 让模型掌握领域语言风格 | 话术、格式、领域表达 | 注入频繁变化的事实与权限 | 微调管"会说",本体管"说对、做对" |
1.1 用同一个问题试一试
抽象的对比容易流于口号。我们拿示例商城客服每天都会遇到的一句话来"压力测试"各个方案:
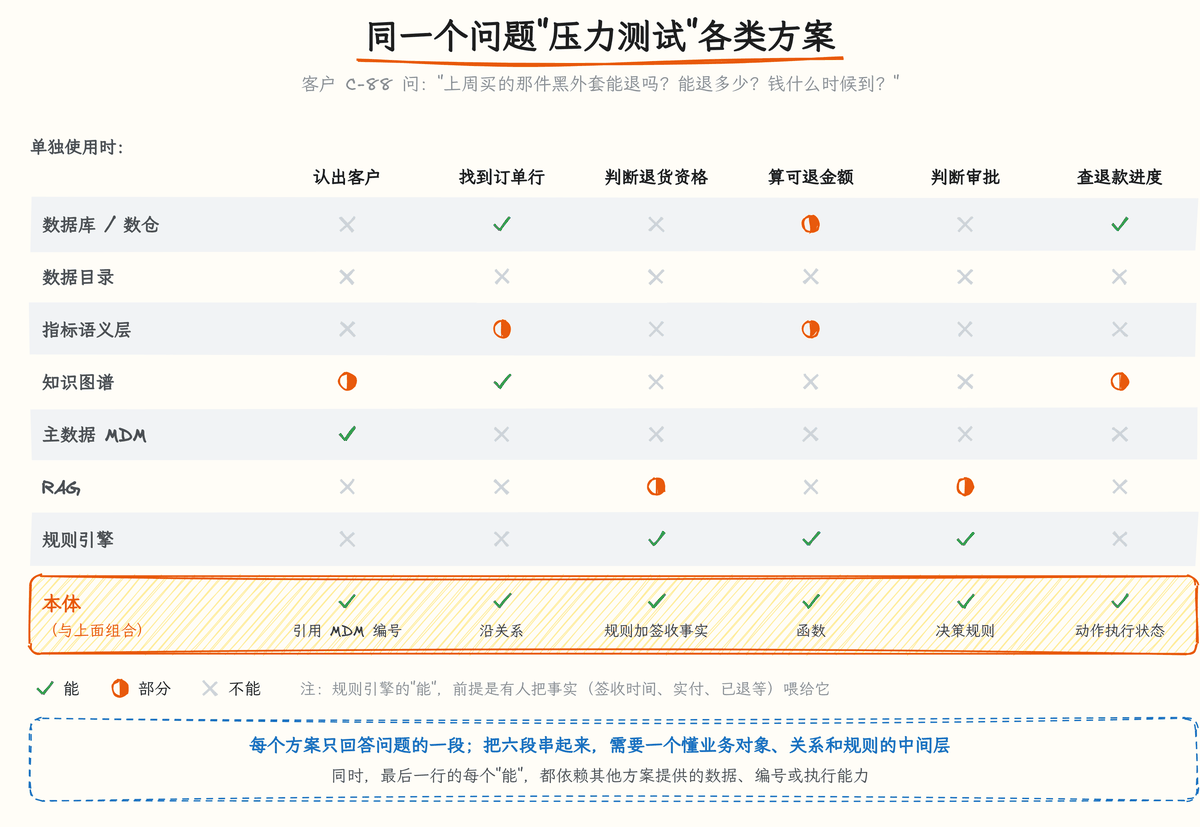
客户 C-88 问:"上周买的那件黑外套能退吗?能退多少?钱什么时候到?"
要完整回答,系统得做六件事:认出客户(他有两个账号)、找到对应订单行、判断是否还在无理由退货期、算出可退金额、判断是否需要主管审批、查到退款当前卡在哪一步。下表是各方案在单独使用时能完成的部分:
| 方案 | 认出客户 | 找到订单行 | 判断退货资格 | 算可退金额 | 判断审批 | 查退款进度 |
|---|---|---|---|---|---|---|
| 数据库 / 数仓 | 不能(不知道两个账号是同一人) | 能(靠人写 Join) | 不能(规则不在库里) | 部分(要人写 SQL) | 不能 | 能(要知道查哪张表) |
| 数据目录 | 不能 | 不能(只知道表在哪) | 不能 | 不能 | 不能 | 不能 |
| 指标语义层 | 不能 | 部分 | 不能 | 部分(擅长汇总,不擅长单笔逻辑) | 不能 | 不能 |
| 知识图谱 | 部分(若做过实体对齐) | 能 | 不能(单独使用时没有规则) | 不能 | 不能 | 部分(若同步了状态) |
| 主数据 MDM | 能 | 不能 | 不能 | 不能 | 不能 | 不能 |
| RAG | 不能 | 不能 | 部分(能找到政策原文,但不知道这单是否已签收) | 不能 | 部分(能找到制度) | 不能 |
| 规则引擎 | 不能 | 不能 | 能(前提是有人把事实喂给它) | 能(同样要有人喂入实付、已退等事实) | 能 | 不能 |
| 本体(与上面组合) | 能(引用 MDM 编号) | 能(沿关系) | 能(规则加签收事实) | 能(函数) | 能(决策规则) | 能(动作执行状态) |
这张表不是说其他方案"不行",而是说明一件事:每个方案只回答问题的一段,真正把六段串起来,需要一个知道"客户、订单行、售后单、退款单是什么、怎么连、受什么规则约束"的中间层。这正是本体的位置。同时也要看到,最后一行的"能",每一格背后都依赖其他方案提供的数据、编号或执行能力。
下面逐个展开,仍以示例商城售后为例。
2. 关系数据库与数据仓库
数据库和数仓是企业数据的家,负责"存得下、算得快、不出错"。它们采用封闭世界假设(没记录就当不存在),擅长事务和聚合,但表结构是为存储和性能设计的:status=5、refund_flag=1 的含义要靠文档和经验。
本体的优势在于给这些表"配上业务说明",并把多张表整合成一个对象。本体的劣势是它本身不擅长海量计算,也不该替代数据库的事务能力。
组合方式:业务数据的当前值留在源系统,本体只保存语义骨架、映射关系和轻量索引,需要时按主键实时读取;写操作通过动作走业务系统的接口或受控的写回通道。有作者用 12306 做的演示正是这种设计——"业务数据的当前值永远留在源系统"。这是"虚拟化"的路线,Fabric IQ 也是这么做的:源数据留在所属系统,需要图查询时再另行选择物化。Palantir 一类平台则通常把数据同步、索引进本体自己的存储,换取查询性能和跨源分析,代价是要处理数据的新鲜度。两条路线的取舍见第 09 篇。
数仓里已有的语义:维度模型里的事实、维度、粒度、一致性维度,本身就是业务语义的一部分。可以把业务数据库、维度模型、指标语义层、本体看成一条连续谱,每往右一步,写下的业务含义就更多(见第 01 篇 8.1 节)。也正因为如此,引入本体不必更换数据库:本体可以只是一层逻辑模型,通过映射指向现有的表,把按业务概念提出的查询改写成 SQL,交给数据库执行(标准和原理见第 09 篇 1.4 节)。一句话概括:本体解释世界,SQL 负责计算。
3. 数据目录与元数据管理
数据目录(Data Catalog)是企业数据资产的"图书目录":有哪些库表、字段什么意思、谁负责、数据从哪来。它和本体最容易混淆,因为两者都在"描述数据"。
区别在于:目录描述的是数据资产(这张表、这个字段),本体描述的是业务世界(客户、订单、退款)。目录告诉你"refund_apply.amount 是申请金额,负责人是售后组";本体告诉你"申请金额属于售后单,不能超过可退金额,只有在待退款状态下才能发起退款"。
厂商 Collibra 的文章把术语表、目录、知识图谱、指标语义层和"连接到资产的本体"放在一起比较,主张本体要和受治理的数据资产相连才有价值。也有实践者在做完本体数据 Agent 后坦言:多数不涉及多跳关系的问题,元数据加目录治理已经够用。组合方式:目录负责物理事实(表、字段、血缘、权限),本体负责业务语义,二者通过数据绑定相连。
4. 指标语义层
指标语义层(Semantic Layer,业内常简称"语义层",也叫指标层)是在数仓之上统一定义指标和维度的一层,让"退款率""GMV"在所有报表里算法一致,dbt、Cube、各数仓厂商都有类似产品。注意它和第 04 篇里本体的"名词层"不是一回事,本系列只在这个意义上使用"指标语义层"一词。
数据治理厂商 Atlan 的概括很好记:语义层管度量,本体管含义(这里的语义层即指标语义层);指标语义层用来查数,本体用来提供上下文和推理。指标语义层知道"退款率 = 发生过成功退款的订单行数 ÷ 已签收订单行数",但不知道"售后单针对订单行""超阈值退款要审批"。Atlan 还给出过建设周期的估计(本体 6 到 18 个月,指标语义层 2 到 6 个月),这是厂商观点,仅供参考。
组合方式:本体定义对象和关系,指标层定义度量,指标挂在对象上。微软 Fabric IQ 的本体就直接沿用 Power BI 的度量作为指标,并支持从已有的语义模型生成本体初稿——不过生成后,时间序列绑定、主键、关系绑定等仍需手工补全。
4.1 看两个具体产品
为了说清楚指标语义层"管到哪",看两个公开文档写得比较清楚的例子:
- Snowflake 语义视图:它是数据库里的一种模式级对象,用"逻辑表"对应客户、订单等业务实体,在逻辑表之间按共享键定义关系,并在上面定义三类东西——事实(行级的数值,如单笔金额)、指标(跨行聚合,如总收入)、维度(分组的角度,如日期、地区、品类)。官方文档举的例子是:数据库里一个叫
amt_ttl_pre_dsc的列,业务上其实是"折前总收入";语义视图把它命名清楚,并把"净收入"统一定义成一种聚合方式,避免几十份报表各算各的。它的 AI 能力会读取这些定义,再直接对物理表生成 SQL。 - dbt 的 MetricFlow:用 YAML 文件定义"语义模型"和"指标"。语义模型包含实体(连接用的键)、维度和简单指标;指标可以是比率、累计、派生、转化等类型。它把这些模型之间的连接称为"语义图",查询时自动找出表之间的最佳连接路径,并通过区分键的类型来避免常见的重复计数问题。MetricFlow 以 Apache 2.0 许可开源。
两者都在做"把数据的业务含义写清楚",而且也有"实体"和"关系"的概念——这正是指标语义层和本体容易混淆的原因。区别在于它们的终点:指标语义层的终点是一个正确的数字,本体的终点是一个正确的判断或动作。
4.2 示例商城的"退款率"放在哪
# 指标层:负责"退款率"怎么算(示意)
metric: refund_rate
type: ratio
numerator: refunded_order_lines      # 签收后发生过至少一笔成功退款的订单行数(按订单行去重)
denominator: signed_order_lines      # 已签收的订单行数(按签收月份归属)
dimensions: [category, month, channel]
# 本体:负责"已退款"是什么、怎么变成已退款(示意)
object_type: AfterSalesCase
status_enum: [待审核, 待退货, 退货验收中, 待退款, 退款中, 已退款, 已关闭]
transition: 退款中 → 已退款  # 仅在支付渠道回执成功时发生
action: initiate_refund       # 唯一允许进入"退款中"的入口
指标层引用本体里的状态定义来计数,本体不关心"按月按品类汇总"。如果哪天业务决定"部分退款也算进退款率",改的是指标层;如果业务决定"验收不合格但给了补偿款"也算一种退款结果,改的是本体里退款单的定义,指标会跟着变。两层各管一段,分工清楚。还要注意一点:口径一变,历史月份是否按新口径重算,要明确做出决定,并在指标说明里标注口径版本,否则新旧报表会对不上。
5. 知识图谱
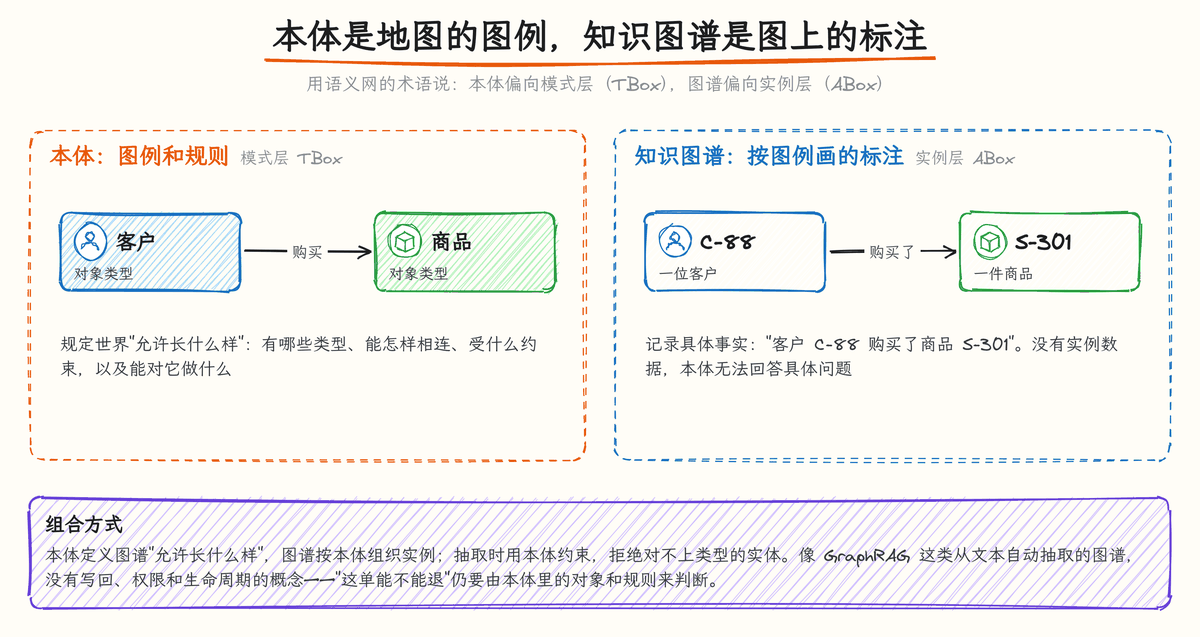
知识图谱(Knowledge Graph)是用"节点 + 边"记录具体事实的网络,例如"客户 C-88 购买了商品 S-301"。它和本体经常一起出现,关系可以这样理解:本体是地图的图例和规则,知识图谱是按图例画在地图上的标注。用语义网的术语说,本体偏向模式层(TBox),图谱偏向实例层(ABox)。
本体的优势在于约束和动作:图谱能告诉你 A 和 B 有关系,却说不清"什么样的关系组合构成风险""能对它做什么"。像 GraphRAG 这类从文本自动抽取的图谱,更没有写回、权限和生命周期的概念。本体的劣势是没有实例数据就无法回答具体问题。
组合方式:本体定义图谱"允许长什么样",图谱按本体组织实例;抽取时用本体约束,拒绝对不上类型的实体。
5.1 自动抽取的图谱和企业本体差在哪
近两年流行的 GraphRAG 一类方案,会从文档中自动抽取实体和关系,形成图谱供检索使用。它和企业本体经常被混为一谈,两者的差别可以这样对照:
| 对比项 | 自动抽取的图谱(如 GraphRAG) | 企业本体 |
|---|---|---|
| 目标 | 让检索更全面、能做主题总结 | 让业务语义统一、让动作受控 |
| 对象从哪来 | 从文本中自动抽取,类型较松散 | 由业务定义、由裁决人确认 |
| 输出 | 相关段落、社区摘要 | 对象、状态、规则判断、动作结果 |
| 写回 | 一般没有 | 动作把结果写回业务系统 |
| 权限 | 通常按文档权限 | 对象级、字段级、动作级 |
| 生命周期 | 重新抽取即更新 | 有版本、有评审、有回归测试 |
在示例商城里,可以用图谱把历年客服对话和售后政策组织起来,帮"小售"找到相似案例;但"这单能不能退"必须由本体里的对象和规则来判断。
6. 主数据管理(MDM)
主数据管理负责为客户、商品、供应商等核心实体维护一份权威的"黄金记录"(合并各系统数据后公认最准确的那一条),有数据管家(负责审核和维护主数据质量的人)负责审核,结果写回各源系统。
MDM 和本体都关心"同一个东西在不同系统里是不是同一个"。区别是:MDM 深耕少数核心实体,追求一份准确的记录;本体横跨多个领域,追求实体之间的连接和业务语义。一篇厂商博客建议两者混合使用:共享稳定的实体 ID,MDM 保证"客户是谁",本体负责"客户和订单、售后、工单怎么连"。
组合方式:本体中的客户、商品直接引用 MDM 的标准 ID,不另造身份。
举个例子:示例商城的会员系统和小程序各有一套客户编号,MDM 负责把它们归并成唯一的客户编号,并维护手机号、地址这些主属性的"标准值"。本体里的"客户"对象直接用这个编号做主键,再挂上订单、售后单、工单等关系。如果没有 MDM,本体只能自己做身份归并——这是可以的,但要承担数据管家的职责,而这本来不是本体团队擅长的事。
7. RAG 与向量数据库
RAG 和向量库负责从文档里找相关片段,是处理非结构化知识的主力。第 03 篇已经讲过它的局限:相似不等于逻辑相关,文档不等于业务状态。
组合方式:本体管"怎么查",向量库管"查证据",大模型管"组织答案"。实践中,主数据进本体和实体索引,交易事实留在源系统实时查,非结构化文档才进向量库。有作者说得直白:"把一亿条订单做成向量没有意义。"
不同类型的数据,适合放在不同地方。一位作者给出的分层建议很实用,放到示例商城大致是这样:
| 数据类型 | 示例商城的例子 | 放在哪里 |
|---|---|---|
| 非结构化文档 | 售后政策、客服话术、培训材料 | RAG 向量库,必要时整理成知识页面 |
| 主数据 | 客户、商品、仓库 | 本体对象和实体索引(编号、别名、关系) |
| 交易事实 | 订单、支付流水、物流轨迹 | 留在源系统,本体登记语义,按需实时查询 |
| 工具接口 | 退款接口、工单接口 | 工具目录,登记能力、参数、权限 |
| 事件日志 | 状态变更、审批记录 | 事件类型和状态机定义在本体,日志留在日志系统 |
8. BI 报表与 ChatBI
BI 负责把数据变成图表和看板,ChatBI 让人可以用自然语言问数。它们的问题有两个:一是口径,有实践者遇到过 ChatBI 把"收货准时率"答成"发货准时率";二是止步于"看",洞察要靠人转成行动。
组合方式:BI 建在本体和指标层之上,口径统一;从看板上发现"某商品退货率异常",可以直接触发本体里的动作(例如"发起质量排查工单"),而不是截图发群。
9. 数字孪生
数字孪生是对物理世界的数字镜像,常见于楼宇、工厂、能源。微软 Azure Digital Twins 把一套用 DTDL 语言写成的领域模型称为"本体",主要描述设备、空间及其遥测数据。
Palantir 也把自己的本体称为组织的"数字孪生",但重心在业务决策。两者可以这样区分:物联网孪生关心"设备现在什么状态",业务本体关心"业务对象现在什么状态、该做什么决定"。组合方式:制造、物流企业可以把设备孪生作为本体中的一部分对象来源。
10. 规则引擎与流程引擎(BPM)
规则引擎负责执行"如果…就…"的判断,流程引擎负责编排多步骤的审批和任务流转。OMG 的 DMN 标准描述决策,BPMN 标准描述流程,两者常配合使用。
规则引擎和本体都在处理规则,但侧重不同:规则引擎关心"怎么高效执行",本体关心"规则说的是哪个对象、哪个属性、在哪个动作里生效"。没有本体,规则里的"订单金额"到底指实付还是应付,仍然要靠约定。
关于流程,有实践者提出"对象链即流程":流程天天变,对象和对象之间的引用关系相对稳定,因此建模时应以对象为主、弱化流程。组合方式:本体定义名词和动作,决策表和流程引擎引用本体里的定义来执行。
在示例商城,第 04 篇的审批决策表就适合交给规则引擎执行。分工可以是:本体定义决策表的输入是"售后单.申请金额"和"商品.类别"(明确是哪个对象的哪个属性、什么单位),规则引擎负责高效求值,本体的"发起退款"动作在前置条件里调用这张决策表,并记录用了哪个版本。这样业务人员改阈值时只改决策表,不必改动作,也不必改代码。
11. 大模型微调
微调能让模型熟悉领域术语、话术风格和输出格式,但研究表明它不擅长可靠地注入新事实(第 03 篇已介绍),更不能承载权限。组合方式:微调可以让 AI 客服说话更像示例商城的客服;本体保证它查的是对的数据、做的是被允许的事。
12. 一个公道的反方意见
也有人认为本体是"旧瓶装新酒":领域驱动设计里的聚合根(一组需要一起保持一致的对象的入口对象)早就把实体和行为绑在一起;Salesforce 这类元数据驱动的系统本身就是很好的本体;跨系统统一有主数据、数据治理和企业服务总线(ESB,在系统之间统一转发和转换消息的中间件)。这些批评提醒我们:本体的很多思想并不新,如果你的系统已经有清晰的领域模型和元数据,本体可能只是给它们换个名字、补上 AI 可读的接口。判断标准不是"有没有叫本体的东西",而是业务语义、动作和权限是否集中、明确、可被机器使用。
13. 组合起来的样子
| 你最想解决的问题 | 优先考虑 |
|---|---|
| 报表口径不一致 | 指标语义层 |
| 不知道公司有哪些数据 | 数据目录 |
| 客户或商品重复、不一致 | 主数据管理 |
| 员工找不到政策文档 | RAG |
| 需要发现隐藏的关联关系 | 知识图谱 |
| 跨系统的业务对象、规则和动作要统一,并让 AI 在授权内办事 | 本体,并与上述方案组合 |
14. 三种常见的组合模式
把上面的方案组合起来,实践中大致有三种模式:
| 模式 | 做法 | 适合 | 代价 |
|---|---|---|---|
| A 指标层优先 | 先建指标语义层,Agent 以问数为主;本体只做薄薄一层对象说明 | 需求以报表、分析为主,几乎没有写操作 | 后续要加动作时,需要补对象身份和规则 |
| B 本体薄层 | 在现有系统之上建本体:数据留在原处,复用 MDM 编号和业务系统权限,动作走业务接口 | 已有成熟业务系统,想让 Agent 在授权内办事 | 跨系统一致性、映射维护需要专人负责 |
| C 平台一体化 | 选一个运营本体平台,把数据接入、本体、应用、Agent 放在同一平台 | 预算充足、系统老旧或分散、愿意平台化 | 平台依赖重,迁移成本高 |
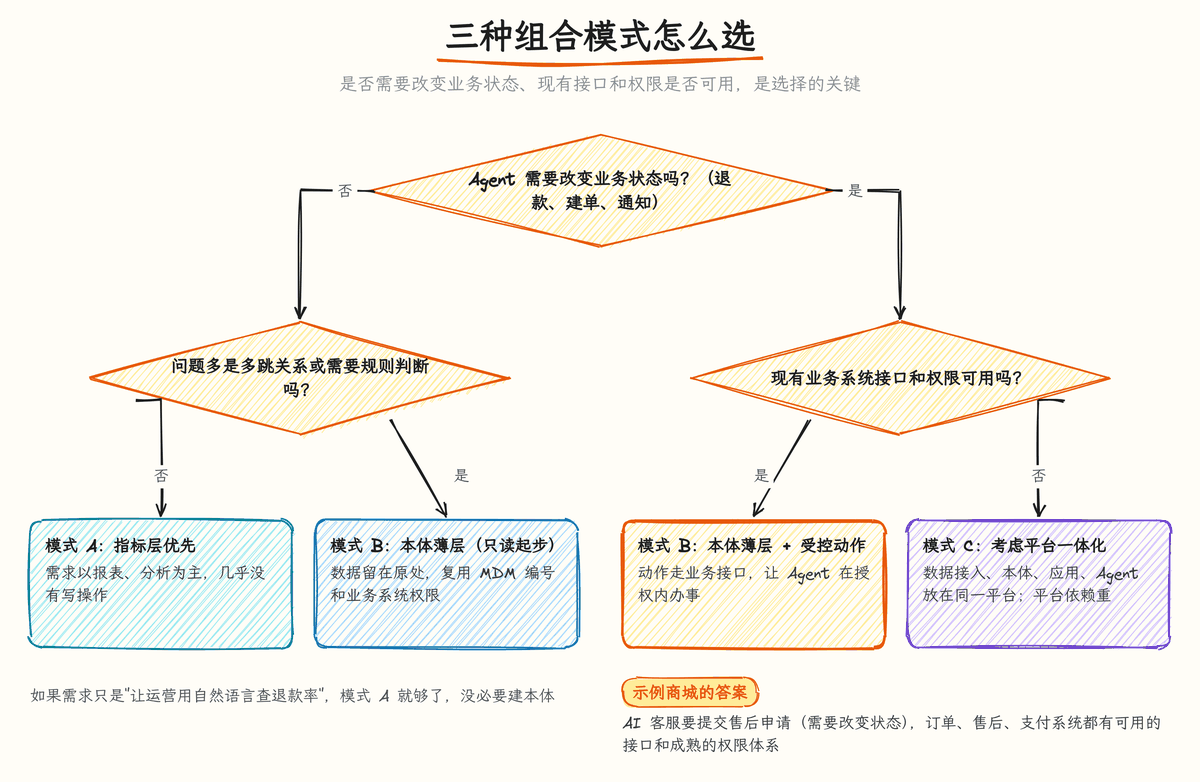
示例商城的答案是模式 B:AI 客服要提交售后申请(需要改变状态),而订单、售后、支付系统都有可用的接口和成熟的权限体系。如果它的需求只是"让运营用自然语言查退款率",模式 A 就够了,没必要建本体。
15. 从已有资产长出本体
很多团队担心"建本体要从零开始"。其实大部分企业已经有不少可以复用的资产:
- 从语义模型起步:已有 BI 语义模型或指标层的团队,可以把其中的实体和关系作为本体初稿。微软 Fabric IQ 就支持从 Power BI 语义模型生成本体,但官方文档也说明,主键、关系绑定、时间序列绑定等需要生成后手工补全。
- 从数据目录起步:目录里的业务术语表和字段说明,是同义词表和属性定义的好素材。
- 从领域模型起步:用领域驱动设计做过建模的系统,其聚合和领域事件往往能直接对应到对象类型和动作。
- 从流程文档起步:制度、SOP 和审批流程图是规则和动作的来源,适合用大模型先抽取初稿,再由领域专家确认(见第 07 篇)。
不管从哪里起步,都要回到第 06 篇的能力问题,检查初稿能不能回答它们。自动生成的模型往往"什么都有一点",却缺少最关键的业务判断。
16. 决策指南:一页纸的选型建议
| 如果你的情况是…… | 建议 |
|---|---|
| 报表口径打架,但业务流程本身很稳定 | 先上指标层,本体暂缓 |
| 客户、商品在各系统里对不上 | 先做 MDM 或身份归并,这是本体的地基 |
| 员工找不到制度和政策 | 先做 RAG,加上文档治理 |
| 要让 AI 回答"这单能不能退、能退多少" | 本体薄层,只读起步,复用 MDM 和规则引擎 |
| 要让 AI 发起退款、建工单 | 本体薄层加受控动作,按第 07 篇的影子模式逐步开放 |
| 系统老旧、接口缺失、数据散落 | 先评估数据治理投入;再考虑平台一体化,并做充分的概念验证 |
| 已有清晰的领域模型和元数据驱动系统 | 把已有模型"翻译"成本体并暴露给 Agent,而不是另建一套 |
17. 常见问题
问:我们已经有指标语义层了,还需要本体吗?
看你的 Agent 要做什么。如果只是问数,指标语义层通常就够了。如果要回答"这一单该怎么处理"并执行动作,就需要对象身份、状态、规则和动作——这些指标语义层一般不管。可以在指标语义层之上补本体,而不是推倒重来。
问:知识图谱和本体要不要分别买两套产品?
不一定。本体是"蓝图",图谱是"按蓝图填的事实"。有的团队用图数据库同时存放两者,有的团队把本体定义放在版本库里的文本文件中、事实留在业务系统。关键是蓝图和事实要分开管理:蓝图走评审,事实走数据管道。
问:本体会不会和主数据团队"抢活"?
会有重叠,所以要事先划界:身份归并和主属性标准值归 MDM,跨领域关系、业务规则和动作归本体。本体引用 MDM 的编号,不另造身份。
问:规则到底写在规则引擎里还是本体里?
规则的"定义"——说的是哪个对象、哪个属性、在哪个动作里生效——写在本体;规则的"求值"可以交给规则引擎。对于少量简单规则,直接在本体服务里实现也可以,但要保证规则有编号、有版本、可读。
问:用微调能不能代替这一切?
不能。微调适合让模型熟悉领域表达方式,但事实和权限都在变,不能训练进模型。第 03 篇介绍过相关研究:注入新知识时,检索类方法总体上优于无监督微调。
本篇要点
- 本体很少替代现有方案,而是在它们之上提供统一的业务语义和受控动作。
- 数据库管存算,目录管资产,指标层管度量,图谱管事实,MDM 管核心实体的权威记录,RAG 管文档证据,BI 管呈现,规则和流程引擎管执行。
- 本体的独特之处是把对象、关系、规则、动作、权限放进同一个模型;它的短板是不擅长海量计算,也不能凭空修复数据。
- 组合时让数据留在源系统,复用主数据 ID 和已有权限,用本体规划查询、用 RAG 找证据。
- 数仓里已经有一部分本体(事实、维度、粒度、一致性维度);本体可以是数仓之上的逻辑层,查询改写成 SQL 执行,不必为此更换数据库。
- 常见组合有三种:指标层优先、本体薄层、平台一体化;是否需要改变业务状态、现有接口和权限是否可用,是选择的关键。
- 如果已有清晰的领域模型和元数据,本体可能只是"补齐 AI 可用的接口",不必另起炉灶。
参考引用
- 《Ontology vs Semantic Layer》,Atlan(厂商博客,含厂商观点)。原文
- 《Connected ontology for enterprise AI》,Collibra(厂商文章,含厂商观点)。原文
- 《Overview of semantic views》,Snowflake 官方文档。原文
- 《About MetricFlow》,dbt Labs 官方文档。原文
- 《Semantic Data Unification vs MDM》,Galaxy(厂商博客,含厂商观点)。原文
- 《Ontology vs Taxonomy vs Knowledge Graph vs Semantic Layer vs Context Graph: A Field Guide》,dataengine 博客。原文
- 《What is ontology (preview)? — Microsoft Fabric IQ》,Microsoft Learn。原文
- 《Generate an ontology (preview) from a semantic model》,Microsoft Learn。原文
- 《What is an ontology? — Azure Digital Twins》,Microsoft Learn。原文
- 《Ontology building: Overview》,Palantir Foundry 官方文档。原文
- 《Decision Model and Notation (DMN) 1.6》,Object Management Group (OMG)。原文
- 《Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs》,Oded Ovadia 等,EMNLP 2024。原文
- 《怎么给客户讲清楚本体论、知识图谱和大模型的关系?》,Alex 科学次位面。Cubox,原文
- 《别把RAG当架构:Ontology(本体)才是Agent的业务世界》,KK AI应用落地社。Cubox,原文
- 《深入浅出学习本体论(Ontology):从哲学根基到实践应用概要》,Tom 汤姆的技术雷达。Cubox,原文
- 《Ontology(本体)Part 3:Ontology (OWL) 驱动的数据分析智能体设计与实战》,Fan 技术与艺术认知。Cubox,原文
- 《分享一个Ontology本体论的AI实操演示,从实际业务看懂本体价值》,月夜烛峰。Cubox,原文
- 《LLM Wiki + Ontology:让企业知识从“可检索”走向“可行动”》,划小船。Cubox,原文
- 《从本体论到本体建模,从本体建模到 AI 原生—我这一年关于本体的系统性复盘》,何明璐 人月聊IT。Cubox,原文
- 《准备上知识图谱和本体(Ontology)?要什么团队、选什么场景、花多少成本 | 人人都是产品经理》,叶小钗。Cubox,原文
- 《让FDE构建本体Ontology就是个伪命题》,杨堃 PM杨堃。Cubox,原文
- 《用OntoFlow本体平台实现“银行资金链路分析模型监控预警”落地方案》,本体智能应用 AbutionGraph。Cubox,原文
- 《企业AI真正缺的不是 SQL,而是Semantic Layer》,本体论应用 AbutionGraph(厂商文章:作者团队开发 OntoFlow 等本体产品,文中观点带有产品立场)。Cubox,原文